Изображение статьи

Нейропоиск: когда ваш контент становится учебником для машин

Денис Тимошин, Руководитель отдела QA

Вы просыпаетесь в мире, где изменились законы гравитации. То, что вчера было лучшей практикой, сегодня работает против вас. Трафик из поиска падает, хотя позиции остаются прежними. Причина — не санкции Google, а фундаментальный сдвиг: контент теперь читают машины, а не люди. 

О том, как поиск меняется из-за ИИ и что это значит для создателей контента, расскажем в этой статье.

poster

От библиотекаря 
к профессору: как изменился поиск

Представьте два способа получить знания. Первый: вы идёте в библиотеку, где опытный библиотекарь показывает вам полки с книгами по вашей теме. Вы сами выбираете, что читать. Так работал Google последние 20 лет.

Второй способ: вы обращаетесь к профессору, который прочитал все книги 
в библиотеке, сжёг её, но сохранил знания в памяти. Он не даёт вам книг — он сразу делится синтезированным ответом, вплетая в него идеи из десятков источников. Так работает нейропоиск.

Это не эволюция — это революция. Масштаб изменений лучше всего характеризует сдержанность самих создателей: в техническом отчёте OpenAI о GPT-4 точный состав и объём обучающих данных не раскрывается — как стратегически важный актив. Это намекает на их колоссальный размер. 
В итоге модель формирует внутреннюю «карту знаний» невообразимой сложности, где ваша статья — лишь один из миллиардов узлов.

poster

Разрыв со старой эпохой

Разрыв первый: страница перестала быть единицей измерения

Раньше SEO-специалисты продумывали и прописывали для каждой страницы Title, Description, H1. Была структура и специфические крючки для того, чтобы машина их видела при анализе контента. Сегодня нейросеть видит 
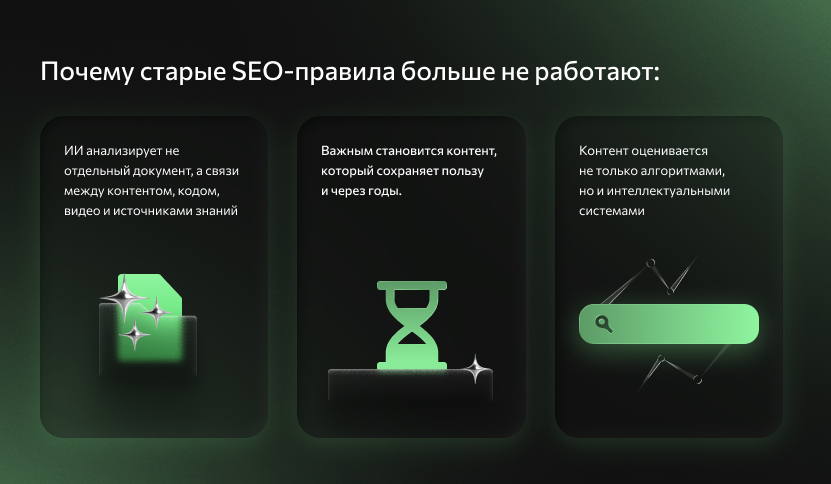
не документ в целом, а семантические паттерны.

Обратимся непосредственно к Google и к его разъяснениям. В описании модели MUM (Multitask Unified Model) Google признается, что алгоритм выстроен иначе и он видит взаимосвязи между концепциями, даже если они никогда не встречались вместе в одном документе. Например, статья 
о «микросервисной архитектуре» уже не конкурирует с другими подобными статьями по теме. Сейчас она рассматривается во взаимосвязи с:

  • документацией Kubernetes;
  • лекциями Мартина Фаулера на YouTube;
  • обсуждениями на Hacker News;
  • кодом из репозиториев GitHub. 

То есть, машина анализирует более глобально и распознает экспертность статей с учетом того, как она переплетена с другими форматами изложения темы.

Разрыв второй: временные рамки сместились 

В традиционном SEO вы боролись за место в выдаче здесь и сейчас. В нейропоиске вы инвестируете в будущее. Data cutoff — дата обрезки данных — становится ключевым понятием. 

Когда OpenAI обучала GPT-4, то использовались актуальные на тот момент данные. Все, что было размещено позже, нейронкой не воспринималось. Соответственно, могла быть устаревшая информация в выдаче ответов. У GPT-5 алгоритм уже другой – машина считывает и ранее опубликованные материалы, и свежий контент. Поэтому перед современным SEO появляется несколько инача задача: размещать на страницах данные, которые будут актуальны с течением времени. 

Пример: статья «Принципы работы блокчейна», опубликованная в 2018 году, до сих пор используется ИИ, потому что объясняет фундаментальные концепции. А вот пост «Курс биткоина сегодня», размещенный в 2023 году, уже забыт. Железный мозг видит, что данные в этом посте не актуальные. 

Разрыв третий: изменились критерии качества 

Раньше главным судьёй были алгоритмы ранжирования. Теперь появился новый арбитр — интеллектуальная система, которую обучают люди. 

Компании, создающие современные модели ИИ (как OpenAI и Anthropic), привлекают тысячи специалистов для обучения систем оценки. Эти люди формируют эталоны, по которым ИИ учится распознавать «хороший» ответ, его полезность, точность, беспристрастность, актуальность. Параметров множество, с течением времени выдача ИИ все лучше и лучше. Если сравнить ИИ-выдачу сейчас и ИИ-выдачу три года назад, получатся кардинально разные ответы. 

Нужно пересматривать и подход к подготовке контента с учетом меняющихся критериев качества.
poster

Архитектура контента для 
эпохи ИИ

Слоистая модель вместо линейного повествования 

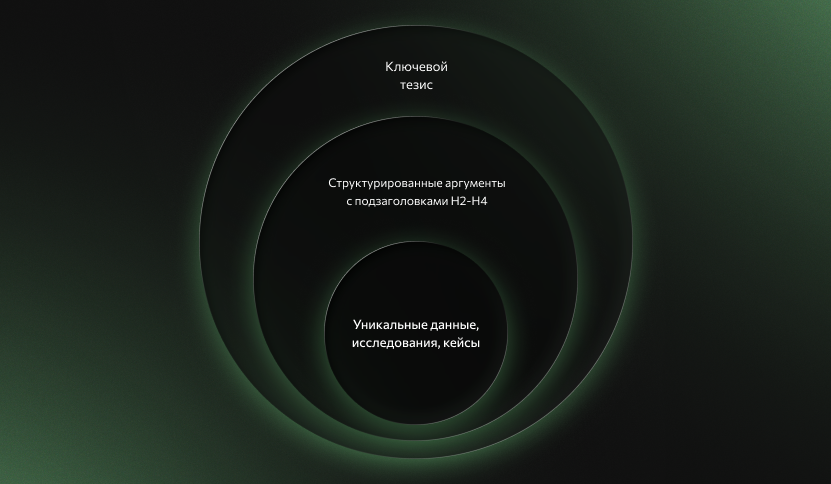
Ваш контент должен быть представлен по принципу матрешки: 

  • Внешний слой: ключевой тезис в первых 100 словах для понимания контекста и темы. Буквально с первого взгляда должно быть понятно, о чем материал.
  • Средний слой: структурированные аргументы с подзаголовками H2-H4, раскрывающими суть повествования.
  • Ядро: уникальные данные, исследования, кейсы, благодаря которым повышается глубина погружения в тему. 

Именно так построена документация MDN Web Docs — ресурс, который ИИ цитирует чаще всего в технических вопросах. Каждая статья начинается с краткого ответа, затем следует глубокое объяснение, примеры кода и ссылки на спецификации. Эту архитектуру можно считать эталонной сегодня.

poster

Цитируемость как новая метрика успеха 

Вместо просмотров страниц измеряйте цитируемость. Проверяйте ее через Perplexity и отслеживайте, использует ли ИИ ваш контент при выдаче ответов по вашей теме. Если нет, то нужно задуматься: почему так происходит, чего не хватает вашим страницам для авторитетности. 

Пример из практики: технический блог Cloudflare ежегодно публикует отчёты о DDoS-атаках. Эти отчёты содержат уникальную статистику, графики, анализ. В результате, когда ИИ отвечает на вопросы о кибербезопасности, он регулярно цитирует Cloudflare как авторитетный источник. 

Мы в Kokoc.tech придерживаемся схожего подхода. При создании материалов стараемся опираться на реальные кейсы, добавлять фактуру и выстраивать многоуровневое повествование, которое раскрывает тему глубже стандартных обзоров. Такой подход уже даёт результат: часть нашего контента начинает восприниматься как авторитетный источник.

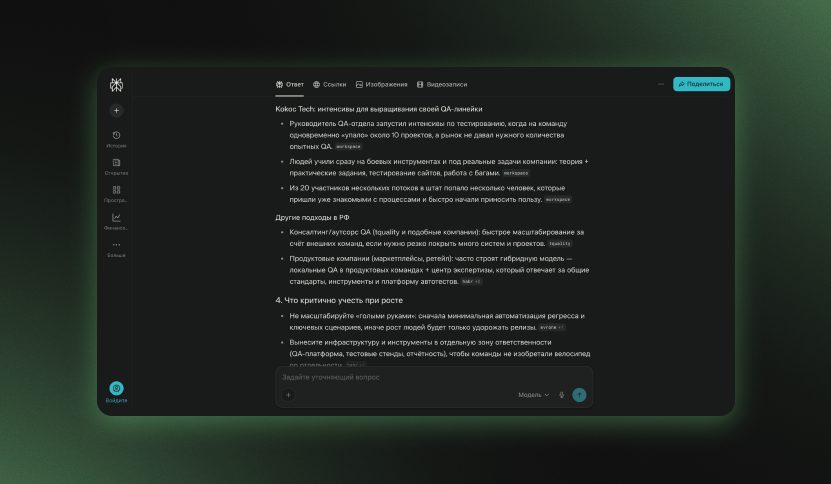
Например, если задать в Perplexity запрос о масштабировании QA-команды среди российских компаний, в числе заметных результатов появляется наша профильная статья:

poster

По каким сигналам ИИ считывает экспертность контента? 

Нейросеть ищет паттерны, отличающие настоящую экспертизу от банального и академичного повествования: 

  1. Глубина погружения: объяснение не только «что», но и «почему», «как»? «что делать».
  2. Ссылки на первоисточники: исследования, RFC, официальную документацию.
  3. Уникальные данные: собственные исследования, опросы, эксперименты, конкретные цифры, сравнительный анализ.
  4. Эволюция взглядов: изменение широты понимания темы со временем.
  5. Признание сообщества: цитирование другими экспертами, наличие ссылок.

Антипаттерны: что больше не работает

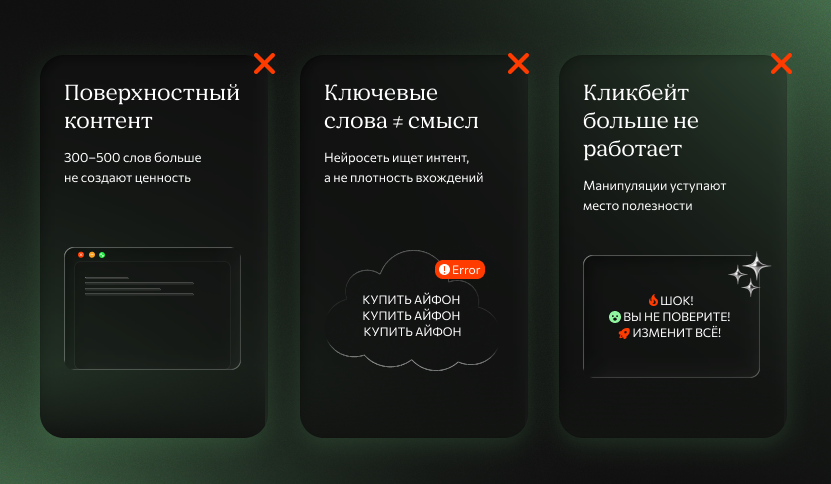
Поверхностный контент 

Больше нет необходимости создавать страницы с текстами объемом 300-500 слов, созданными под низкочастотные запросы. Это не просто не работает. Это может сыграть против вас. Такие материалы активно отфильтровываются при формировании качественных датасетов. 

Ключевые слова как самоцель 

Теряют смысл такие показатели, как плотность ключевых слов, точность вхождения. И даже LSI-фразы уже не представляют прежней ценности. Нейросеть понимает смысл и считывает семантику. Она ищет не слова, а ответы на интенты. 

Пример: статья с 20 упоминаниями «купить iPhone дешево» проиграет обзору, который подробно сравнивает модели, объясняет различия, говорит о плюсах и минусах, даёт рекомендации по выбору. 

Кликбейт и эмоциональные манипуляции 

ИИ научился распознавать манипулятивные приемы. Заголовки из серии: «Вы будете в шоке, но именно это средство….», «Вы не поверите, что случилось дальше» или «Это изменит всё» теперь работают против вас. Громкие, кричащие Н1, сомнительные обещания, категорические заявления использовать не стоит. ИИ понижает их в ранжировании или даже полностью исключает из анализа. Приоритет лучше отдать спокойному изложению с объективным рассмотрением разных аспектов темы.

poster

Практическое руководство

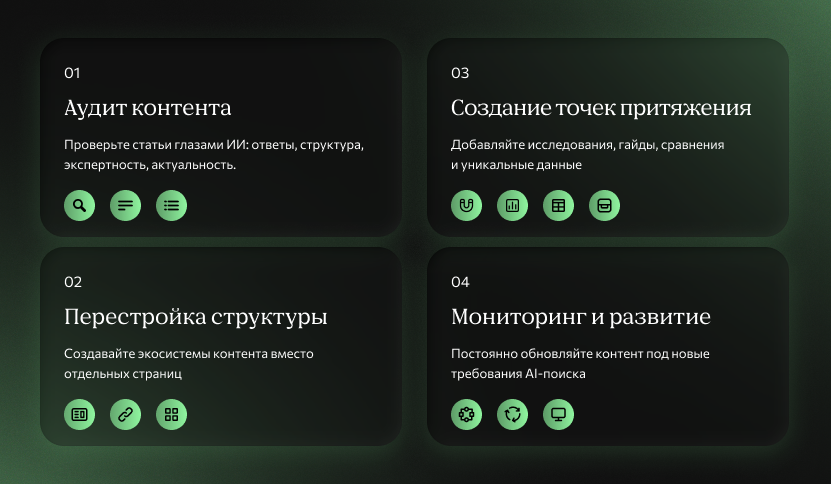
Шаг 1: Аудит контента через призму ИИ 

Возьмите 10 лучших статей, еще раз прочитайте их и попробуйте оценить их со стороны, нейтральным взглядом. 

Задайте себе вопросы: 

  • Можно ли извлечь из статьи готовый ответ на конкретный вопрос («что это», «как применять», «противопоказания» и др.).
  • Есть ли в первых двух абзацах ключевой тезис, раскрывающий суть материала?
  • Используются ли списки, таблицы, определения, есть ли мнение эксперта?
  • Ссылаетесь ли вы на авторитетные источники? Дополнили ли вы статью фото, видеоматериалами?
  • Сохранит ли материал актуальность через год? 

Шаг 2: Перестройка архитектуры 

Выберите главную тему, в которой вы разбираетесь. Измените подход к подготовке контента: не пишите просто статью. Создайте микросайт внутри сайта. 

Архитектура страницы: 

  • Введение: обзор темы с навигацией и содержанием.
  • Серединная часть: подтемы с глубоким погружением, детальным описанием, расмотрением не только преимуществ, но и недостатков.
  • Глоссарий: определения терминов, расшифровки и прочее.
  • Справочные материалы: таблицы, чек-листы, схемы.
  • Мнение экспертов: общие мнения, альтернативные мнения. 

Пример: вместо 20 статей о разных аспектах SEO создайте «Энциклопедию поисковой оптимизации». Добавьте перекрестные ссылки, выдержки из интервью с экспертами, конкретными кейсами и примерами. 

Шаг 3: Поиск магнитов-крючков 

Добавьте в свой материал магниты, которые приковывают внимание и цепляют своей неординарностью, экспертностью. Сделайте так, чтобы ваш контент хотелось цитировать. 

Можно добавить: 

  • Исчерпывающие гайды с пошаговыми инструкциями;
  • Исследования с уникальной методологией и данными;
  • Сравнительные таблицы;
  • Обзор различных концепций;
  • Интерактивные инструменты с открытым API.

Шаг 4: Мониторинг и адаптация 

Раз в месяц проверяйте: 

  • Цитирует ли Perplexity ваши материалы?
  • Какие источники ИИ использует по вашей теме?
  • Кто из конкурентов попадает в выдачу?
  • Какие формулировки и структуры он заимствует?
  • Что есть в других материалах, и чего нет у вас?
  • Как меняется выдача AI-поисковиков? 

По мере обнаружения пробелов вносите корректировки в уже опубликованные статьи, адаптируйте их под меняющиеся критерии качества. Также можно менять цифры и данные: например, каждый январь менять в статье даты. Например: «Что подарить на 23 февраля в 2025 году» измените на «Что подарить на 23 февраля в 2026 году».

poster

Будущее, которое 
мы наблюдаем 
уже сейчас

Тренд 1: Персонализированные модели 

Крупные компании начинают обучать собственные ИИ на внутренних данных. Ваш контент может стать частью корпоративной базы знаний, как документация Microsoft или гайды GitLab. Вы тоже можете инвестировать в персональные модели. 

Тренд 2: Прямые соглашения 

Уже сегодня ведутся переговоры между медиакомпаниями и разработчиками ИИ о компенсациях за использование контента. Качественные материалы могут стать активом, приносящим пассивный доход. Может не сейчас, но в перспективе вы тоже может получать прибыль от своего контента 

Тренд 3: Контекстные агенты

ИИ будущего будет не просто отвечать на вопросы, а решать конкретные проблемы. Он сможет использовать ваш контент для: 

  • составления бизнес-планов на основе ваших кейсов;
  • диагностики проблем по вашим руководствам;
  • обучения сотрудников по вашим методикам. 

С помощью ИИ можно ускорить ряд процессов, снизить объем коммуникации и оптимизировать рабочие схемы взаимодействия.

Заключение: новая роль создателя контента

Теперь вы не просто автор. Вы — архитектор знаний, чьи работы становятся частью коллективного интеллекта человечества. 

Спросите себя сегодня: через три года, когда ИИ будет отвечать на вопрос по вашей теме, какой фрагмент из ваших материалов он процитирует? Если ответа нет — у вас есть работа. Если есть — вы уже строите будущее. 

Нейропоиск — это не апокалипсис для SEO. Это возрождение настоящего, глубокого, экспертного контента. В мире, где машины учатся на наших текстах, только одно имеет значение: быть источником истины, а не шума.

Экспресс лендинг за 2 недели

Выполним полноценный лендинг по фиксированной цене 250 000 ₽

Скачать презентацию
1.0.12